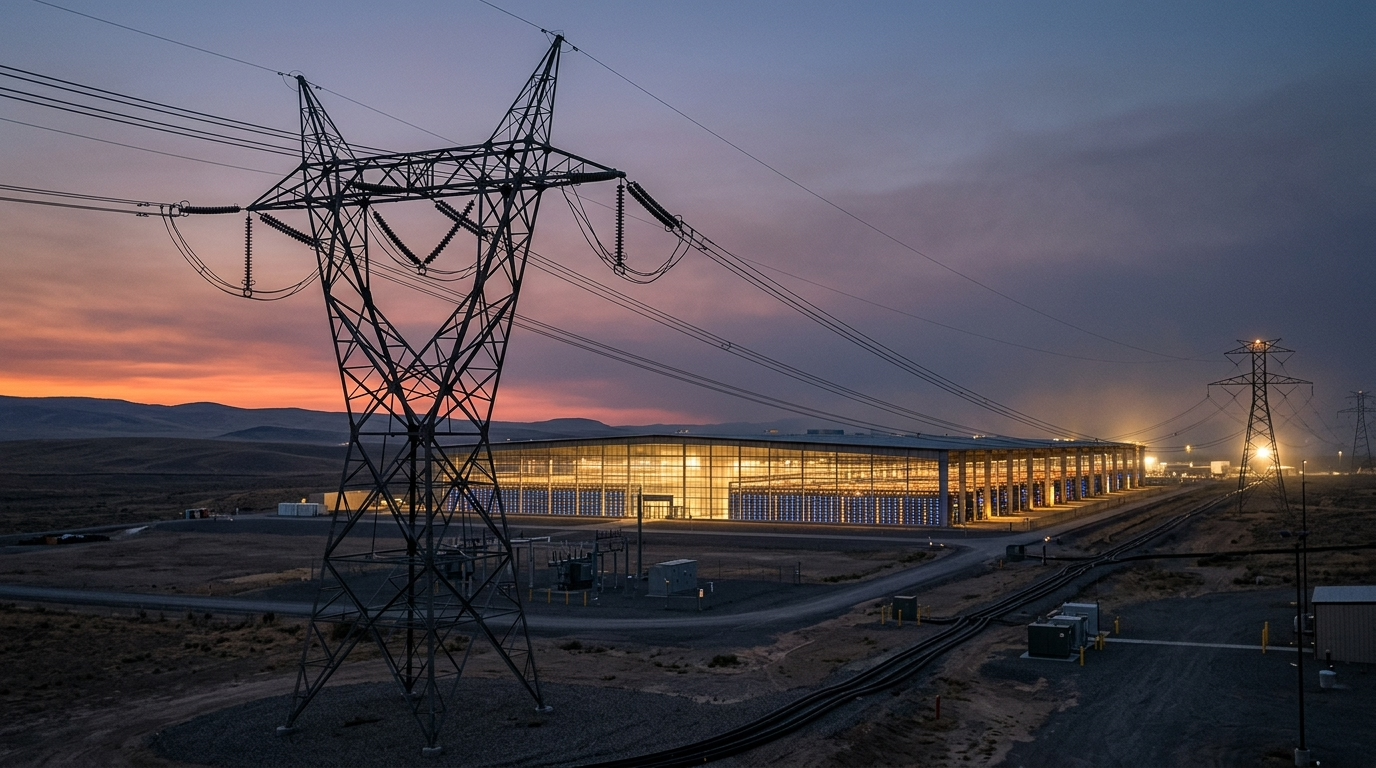
Op 22 juli 2026 viel in enkele seconden meer dan 3 gigawatt aan datacentercapaciteit uit het Amerikaanse stroomnet, meldt E&E News. Niet door een tekort aan stroom, maar door de manier waarop al die datacenters op het net zijn aangesloten. En dat raakt jou meer dan je denkt.
Want jij beheert geen datacenter. Toch stuur je vandaag facturen vanuit de cloud, werkt je team samen in Microsoft 365 en laat je misschien een AI-tool je offertes voorbereiden. Achter elk van die dagelijkse handelingen zit een infrastructuur waar je nooit bij stilstaat, tot ze even niet werkt. Tijd om die vanzelfsprekendheid eens tegen het licht te houden.
Het probleem in Virginia was geen stroomtekort. Dat is het belangrijkste om te begrijpen. Er was stroom genoeg; de manier waarop de datacenters reageerden op een kleine netstoring zorgde voor de ravage.
Ashburn in Virginia is de dichtste concentratie van datacenters ter wereld. Toen daar een transmissiestoring optrad, viel in enkele seconden meer dan 3 gigawatt weg. Twee jaar eerder gebeurde iets vergelijkbaars: een defecte overspanningsafleider legde in één klap ongeveer zestig datacenters en 1.500 megawatt stil.
Waarom telkens zo massaal en zo plots? Omdat al die datacenters bijna identiek zijn opgebouwd en dus tegelijk reageren op dezelfde prikkel. Volgens MIT Technology Review is dat de kern van de zaak: het gaat niet om te weinig opwekking, maar om een architectuurprobleem. Enorme, gelijkaardige IT-belasting die als één blok van het net springt. Bouw je een net vol identieke, hongerige buren, dan struikelen ze ook allemaal tegelijk over dezelfde drempel.
Dit is geen ver-van-mijn-bed-verhaal dat enkel in de VS speelt. De onderliggende dynamiek, veel AI-vraag geconcentreerd in enkele hubs, groeit ook hier stevig.
Europa wil zijn datacentercapaciteit minstens verdrievoudigen tegen 2030, geeft de IEA aan. Meer datacenters betekent ook meer druk op het net. Netbeperkingen en jarenlange aansluitwachttijden vormen daarom een hoofdknelpunt.
Die druk is niet gelijk verdeeld. In sommige Europese hubs is al 33 tot 42 procent van de elektriciteitsvraag datacenter-gerelateerd. In Dublin loopt dat zelfs op tot bijna 80 procent. Met andere woorden: op die plekken hangt het net grotendeels aan een klein aantal grote verbruikers. Die concentratie is precies het patroon dat in Virginia misging.
Betekent dit dat je Belgische clouddienst morgen uitvalt? Nee, zo ver gaat het niet. Er is geen bewezen keten tussen een Amerikaans incident en een dienst die jij gebruikt. Maar snelle schommelingen in datacentervraag geven spannings- en frequentierisico’s op het net. Simpel gezegd: als het verbruik plots hard op- en neergaat, wordt het net moeilijker stabiel te houden. Dat waarschuwt ENTSO-E, de Europese koepel waar netbeheerder Elia deel van uitmaakt. Het risico is dus reëel en structureel, niet iets wat je met een gerust hart als onmogelijk afdoet.
Concreet betekent dit dat de betrouwbaarheid van je cloud- en AI-diensten deels afhangt van infrastructuur die ver buiten je eigen muren en je eigen controle ligt. Je hebt er geen knop op. Maar je hebt wel keuze in hoe je erop anticipeert.
Vergelijk het even met hoe je andere zakelijke risico’s aanpakt. De meeste kmo’s toetsen een overname of een uitbreiding grondig op risico. Een nieuwe vestiging koop je niet zonder na te gaan wat er kan misgaan.
Vreemd genoeg leunen diezelfde bedrijven volledig op cloud- en AI-leveranciers zonder ooit te vragen hoe robuust die infrastructuur eronder zit. Dat is een blinde vlek. En net die blinde vlek raakt je continuïteit als er iets misgaat.
Je hoeft daarom niet in paniek alles zelf te gaan hosten. Dat is duurder en meestal minder betrouwbaar. De juiste reactie is nuchter: weet waar je diensten draaien, weet wat er gebeurt als één locatie uitvalt, en zorg dat je kritieke processen niet volledig platliggen als de cloud even hapert. Denk aan een offline manier om te blijven factureren of bestellingen te noteren. Rust komt niet van hopen dat het goed zit, maar van weten dat het goed zit.
Geen technische kennis nodig? Klopt. Je moet gewoon de juiste vragen stellen en luisteren of het antwoord concreet is of vaag.
Leg deze vragen op tafel bij je cloud- of IT-leverancier:
Een SLA (Service Level Agreement, de afspraak over gegarandeerde beschikbaarheid) klinkt geruststellend, maar een percentage op papier zegt weinig als niemand kan uitleggen wat er in de praktijk gebeurt bij uitval. Vraag door tot je een concreet antwoord krijgt. Krijg je alleen mooie woorden, dan weet je genoeg. Dit is precies het soort afweging dat we soms samen met klanten van Clear IT bekijken: welke diensten kritiek zijn, en welke vangnet daar tegenover moet staan.
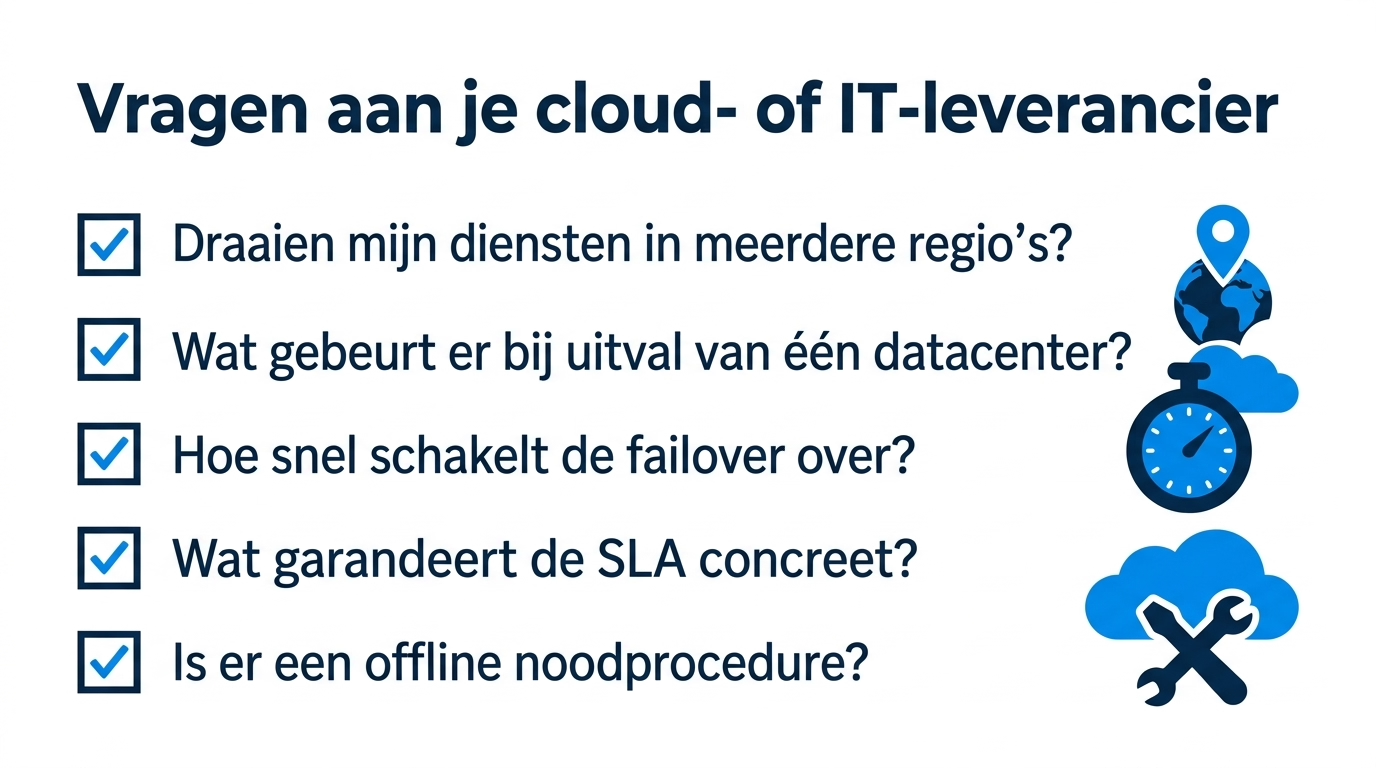
Vendor-infrastructuur is geen technisch detail voor de IT-afdeling, het is een continuïteitsvraag voor de directie. Neem het op waar je het thuishoort: naast je andere groeirisico’s. Bij elke schaalvergroting of overname weeg je voortaan ook af hoe afhankelijk je wordt van cloud- en AI-diensten, en hoe robuust die eronder zitten. Geen paniek, wel inzicht. Doe deze week één concrete check: vraag aan je IT-verantwoordelijke of jullie kritieke diensten in meerdere regio’s draaien én of er een offline noodprocedure klaarligt om te blijven factureren. Krijg je geen helder antwoord, dan weet je meteen welk huiswerk vandaag bovenaan je lijst hoort.
Niet rechtstreeks, want er is geen bewezen link tussen een Amerikaans incident en een Belgische clouddienst. Maar het onderliggende patroon, veel AI-vraag geconcentreerd in enkele hubs, groeit ook in Europa. Het is een structureel risico dat je best mee overweegt bij leverancierskeuzes.
Nee. Zelf hosten is meestal duurder en minder betrouwbaar dan een goede cloudleverancier. De betere aanpak is weten waar je diensten draaien, of ze redundant zijn opgezet, en zorgen dat kritieke processen een offline vangnet hebben.
Redundantie betekent dat je diensten op meerdere plaatsen tegelijk draaien. Valt één datacenter of regio uit, dan neemt een andere het over en werk je verder alsof er niets gebeurd is. Vraag je leverancier concreet of dit voor jouw diensten geregeld is.
Stel concrete vragen over meerdere regio’s, failover en wat er precies gebeurt bij uitval. Krijg je heldere, concrete antwoorden, dan zit het waarschijnlijk goed. Blijft het bij vage geruststellingen, dan is dat een signaal om verder te kijken.