“Een AI-agent is gewoon een slimmere versie van software die we al hadden.” Dat klinkt geruststellend, maar het klopt niet. Een klassiek programma doet exact wat je instelt. Een AI-agent beslist zelf welke stappen hij zet, welke bestanden hij opent en welke informatie hij combineert om een taak af te werken.
Stel je voor: een agent stelt automatisch een offerte op voor een klant. Om dat te doen, haalt hij prijzen uit je boekhouding, marges uit een intern document en kortingsafspraken uit een mailbox. Snel en handig. Tot niemand nog kan zeggen welke gevoelige info precies in die offerte terechtkwam, of waar ze vandaan kwam. Dat is het nieuwe risico waar weinig zaakvoerders bij stilstaan.
Wat gebeurt er als AI-agenten zelf beslissen welke data ze delen?
Dit betekent concreet dat data begint te bewegen zonder dat iemand aan het stuur zit. Een klassiek bestand blijft staan waar je het zet. Een AI-agent trekt daarentegen informatie uit verschillende systemen, combineert die en geeft het resultaat door, soms aan een volgende agent of aan een externe dienst.
Volgens MIT Technology Review ontstaat het echte probleem pas achteraf: wanneer er een fout opduikt, is het vaak onmogelijk te achterhalen waar de verkeerde of niet-goedgekeurde gegevens in de keten zijn binnengekomen. De agent heeft stappen gezet die niemand nog kan reconstrueren.
Voor een kmo is dat geen theoretisch verhaal. Denk aan prijsinformatie die bij de verkeerde klant belandt, of interne marges die in een document opduiken dat naar buiten gaat. Niet omdat iemand slordig was, maar omdat de agent zelfstandig een beslissing nam die niemand controleerde. Hoe meer systemen je aan die agent koppelt, hoe groter de kans dat er iets doorsijpelt.
Waarom klassiek databeheer niet volstaat bij agentische AI
Het punt is dat je oude aanpak van databeheer draait rond stilstaande bestanden, terwijl een AI-agent met bewegende datastromen werkt. Je mappenstructuur, je toegangsrechten per medewerker, je back-ups: dat beheert wie welk bestand mag openen. Maar een agent is geen medewerker met een vast takenpakket. Hij schakelt tussen bronnen en past zijn gedrag aan de situatie aan.
Daarom volstaat het niet langer om te weten wie toegang heeft tot welke map. Je moet ook weten wat de agent met die toegang doet, en of je dat achteraf kan terugvinden. Dat is een ander soort toezicht.
De risico’s zijn trouwens niet voor elke kmo even groot. Een agent die enkel openbare info samenvat, stelt weinig voor. Een agent die bij je boekhouding en klantgegevens kan en zelfstandig naar buiten communiceert, is een heel ander verhaal. De Europese Commissie wijst erop dat traceerbaarheid, duidelijke controlepunten en menselijk toezicht essentieel blijven. Het verschil zit in drie vragen: wat kan de agent zien, waarmee is hij verbonden, en mag hij handelen zonder dat iemand het goedkeurt?
Wat betekent dit voor jouw bedrijf en je leveranciers?
Dit raakt rechtstreeks aan iets waar je als zaakvoerder zelf verantwoordelijk voor blijft: je klantvertrouwen en je aansprakelijkheid. Koop je een AI-tool in via een externe leverancier, dan verschuift het werk, maar niet de verantwoordelijkheid. Als er gevoelige data uitlekt, is dat jouw probleem, niet dat van de softwareleverancier.
Veel kmo’s zetten agentische AI net in via een SaaS-dienst, software die je online afneemt zonder zelf iets te installeren. Handig, maar je ziet vaak niet wat er onder de motorkap gebeurt. En net daar zit het risico: je vertrouwt erop dat de agent netjes binnen de lijntjes blijft, zonder dat iemand je dat zwart op wit garandeert.
Het Centrum voor Cybersecurity België benadrukt het belang van beperkte toegang, goedgekeurde tools en het bijhouden van logs. Vertaald naar AI-agenten: geef een agent niet meer toegang dan strikt nodig, en zorg dat elke stap wordt opgeslagen. Zo kan je bij een incident nog reconstrueren wat er gebeurde. Dat is geen technische luxe, dat is bedrijfscontinuïteit.
Zo behoud je controle zonder zelf technisch te worden
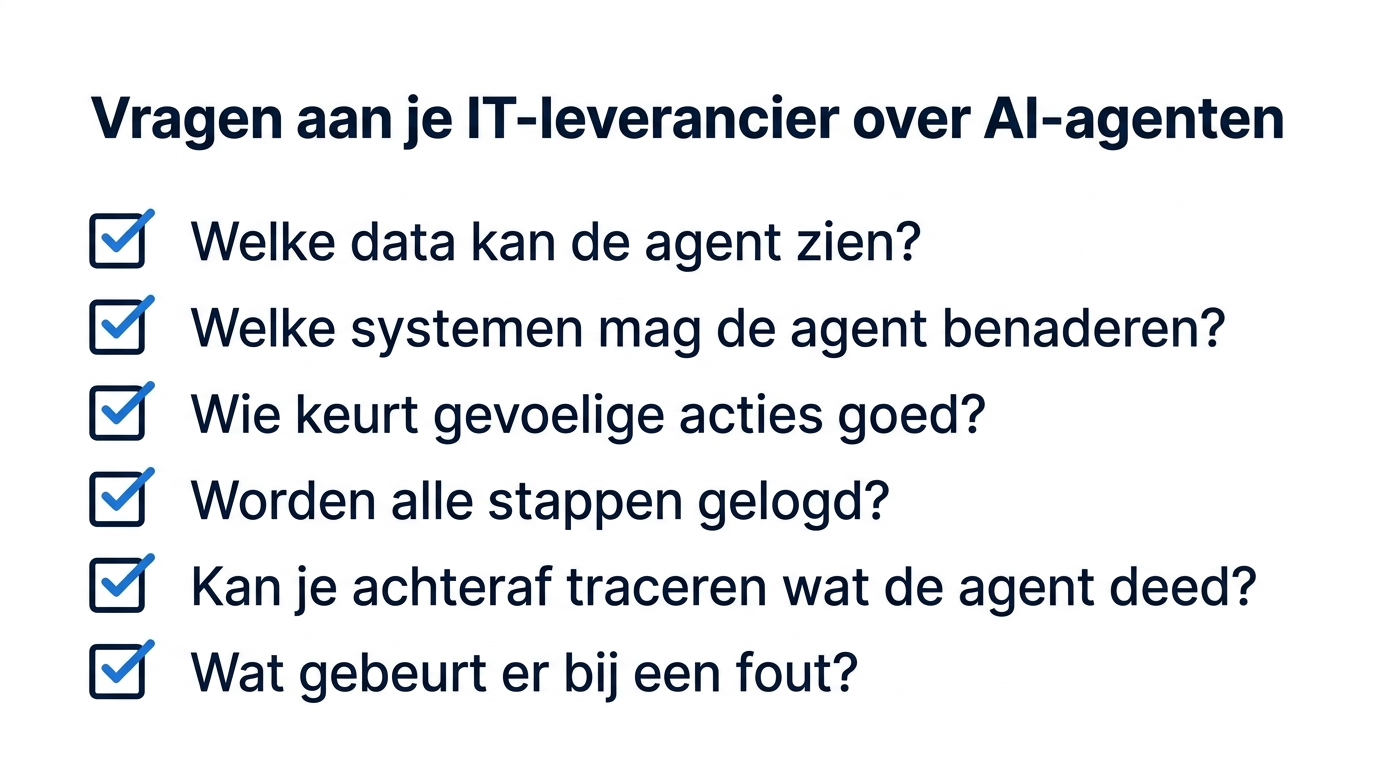
Je hoeft geen expert te worden om grip te houden. Je moet alleen de juiste vragen stellen voordat je een AI-agent omarmt. Welke data kan hij zien? Met welke systemen is hij verbonden? Wie keurt gevoelige acties goed, en wordt alles netjes gelogd zodat je het achteraf kan terugvinden?
Krijg je op die vragen geen helder antwoord, dan is de agent nog niet klaar voor jouw zaak. Dat bekijken we soms samen met klanten: eerst afbakenen wie wat mag zien, dan pas inschakelen. Begin klein en schaal pas op als het vertrouwen er is.
Veelgestelde vragen
Zijn AI-agenten dan te gevaarlijk om te gebruiken?
Nee, ze bieden echte kansen om tijd te winnen en taken te automatiseren. Het risico zit niet in de technologie zelf, maar in een agent die te veel toegang krijgt en zelfstandig mag handelen zonder toezicht. Baken dat vooraf af en het risico blijft beheersbaar.
Geldt dit risico ook voor een kleine kmo?
Ja, maar de omvang verschilt. Een eenvoudige agent die openbare info samenvat, stelt weinig voor. Zodra een agent bij gevoelige data kan, verbonden is met je systemen en zonder goedkeuring handelt, wordt het risico veel groter, ongeacht de grootte van je bedrijf.
Wie is verantwoordelijk als er data uitlekt via een AI-tool?
In de praktijk blijf jij als bedrijf verantwoordelijk tegenover je klanten, ook als je de tool inkoopt bij een externe leverancier. Daarom is het belangrijk om vooraf duidelijke garanties en transparantie te eisen over wat de agent mag en hoe alles wordt gelogd.
Wat vraag ik best aan mijn IT-partner?
Vraag welke data de agent kan zien, met welke systemen hij verbonden is, wie gevoelige acties goedkeurt en of elke stap wordt opgeslagen. Een goede partner kan die vragen helder beantwoorden en denkt mee over wat bij jouw omvang past.